深層学習の代表的なモデル図を TikZ で描く
はじめに
論文や資料で使う深層学習モデルの図 ── 全結合層のニューロン、畳み込みの特徴マップ、Transformer のサブ層構成 ── は、TikZ で描けます。ノードや矩形を並べて矢印でつなぐ、というこれまでのグラフィカルモデル・可換図式・ブロック線図の応用です。
要点は 2 つです。
- 繰り返しは
\foreach:同じ形のニューロンやセルをループで配置する - 層は座標で管理:
x座標を層ごとに決め、positioningのright=of/above=ofで積む
多層パーセプトロン(MLP)
ニューロンを層ごとに \foreach で並べ、層間の全結合を二重ループで引きます。
\begin{tikzpicture}[
  >=Stealth, font=\small,
  neuron/.style={circle, draw, thick, minimum size=7mm, inner sep=0pt},
]
  \foreach \i in {1,2,3}
    \node[neuron] (I\i) at (0, {2-\i}) {};
  \foreach \i in {1,2,3,4}
    \node[neuron, fill=black!6] (H\i) at (2, {2.5-\i}) {};
  \foreach \i in {1,2}
    \node[neuron] (O\i) at (4, {1.5-\i}) {};

  \foreach \i in {1,2,3}
    \foreach \j in {1,2,3,4}
      \draw[->, black!35] (I\i) -- (H\j);
  \foreach \i in {1,2,3,4}
    \foreach \j in {1,2}
      \draw[->, black!35] (H\i) -- (O\j);

  \node[above=6mm of I1] {Input};
  \node[above=6mm of H1] {Hidden};
  \node[above=6mm of O1] {Output};
\end{tikzpicture}
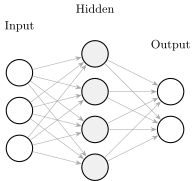
出力例:多層パーセプトロン。各層の $y$ 座標を {2-\\i} のように式で与え、層間を二重 \\foreach で全結合する。
at (0, {2-\i})の{...}は座標の中で式を評価させる書き方。ノード数に応じて中央そろえになるよう定数を決める- エッジは薄いグレー(
black!35)にすると、ノードが埋もれない
畳み込みニューラルネットワーク(CNN)
各ステージを、高さの違う矩形で表します。空間サイズが縮み、チャンネルが増える様子を高さで示し、寸法はラベルに書きます。
\begin{tikzpicture}[
  >=Stealth, font=\footnotesize,
  stage/.style={draw, thick, fill=black!5, minimum width=7mm},
  lbl/.style={align=center, font=\scriptsize, anchor=north},
]
  \node[stage, minimum height=26mm] (x) {};
  \node[stage, minimum height=22mm, right=9mm of x]  (c1) {};
  \node[stage, minimum height=14mm, right=9mm of c1] (p1) {};
  \node[stage, minimum height=11mm, right=9mm of p1] (c2) {};
  \node[stage, minimum height=7mm,  right=9mm of c2] (p2) {};
  \node[draw, thick, fill=black!5, minimum width=4mm, minimum height=18mm,
        right=9mm of p2] (fc) {};
  \node[draw, thick, fill=black!5, minimum width=4mm, minimum height=9mm,
        right=8mm of fc] (out) {};

  \foreach \a/\b in {x/c1, c1/p1, p1/c2, c2/p2, p2/fc, fc/out}
    \draw[->] (\a) -- (\b);

  \coordinate (base) at (0,-1.75);
  \node[lbl] at (x  |- base) {Input\\$28\times28$};
  \node[lbl] at (c1 |- base) {Conv\\$24\times24\times8$};
  \node[lbl] at (p1 |- base) {Pool\\$12\times12\times8$};
  % … 以下同様 …
\end{tikzpicture}
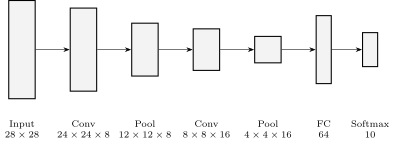
出力例:CNN。ラベルは (ノード |- base) で共通の $y$ 座標にそろえると、高さの違う矩形でも下端が乱れない。
(<ノード> |- <座標>) は「そのノードの $x$、指定座標の $y$」を表す記法です。ラベルをこの $y$ にそろえると、ブロックの高さがばらばらでも一列に並びます。
展開した RNN
再帰セルを時刻方向に \foreach で並べ、隠れ状態を横に、入力と出力を縦につなぎます。
\begin{tikzpicture}[>=Stealth, font=\small,
  cell/.style={draw, thick, rounded corners, minimum size=10mm}]
  \foreach \t in {1,2,3}
    \node[cell] (A\t) at ({(\t-1)*2.4}, 0) {$A$};

  \coordinate[left=1.1cm of A1] (h0);
  \draw[->] (h0) -- node[above]{$h_0$} (A1);
  \draw[->] (A1) -- node[above]{$h_1$} (A2);
  \draw[->] (A2) -- node[above]{$h_2$} (A3);
  \draw[->] (A3) -- node[above]{$h_3$} ++(1.4,0);

  \foreach \t in {1,2,3}{
    \draw[->] ($(A\t)+(0,-1.1)$) node[below]{$x_{\t}$} -- (A\t);
    \draw[->] (A\t) -- ($(A\t)+(0,1.1)$) node[above]{$y_{\t}$};
  }
\end{tikzpicture}
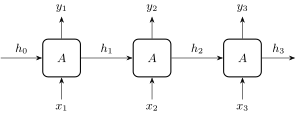
出力例:時刻方向に展開した RNN。セルの $x$ 座標を {(\\t-1)*2.4} で等間隔に置き、$h$・$x_t$・$y_t$ を引く。
Transformer
エンコーダブロック
サブ層(Multi-Head Attention、Feed Forward)と「Add & Norm」を縦に積み、残差結合をサブ層の脇に引き回します。
\begin{tikzpicture}[
  >=Stealth, font=\small, node distance=6mm,
  blk/.style={draw, thick, rounded corners, minimum width=42mm, minimum height=8mm, align=center},
  an/.style ={draw, thick, fill=black!5, minimum width=42mm, minimum height=6mm, align=center},
]
  \coordinate (in);
  \node[blk, above=8mm of in] (mha) {Multi-Head Attention};
  \node[an,  above=of mha]     (an1) {Add \& Norm};
  \node[blk, above=8mm of an1] (ff)  {Feed Forward};
  \node[an,  above=of ff]      (an2) {Add \& Norm};
  \coordinate[above=8mm of an2] (out);

  \draw[->] (in) -- (mha);   \draw[->] (mha) -- (an1);
  \draw[->] (an1) -- (ff);   \draw[->] (ff) -- (an2);
  \draw[->] (an2) -- (out);

  % 残差結合:中点で分岐 → 右へ → Add & Norm の東側へ
  \draw[->] ($(in)!0.5!(mha)$) -- ++(3.1,0) |- (an1.east);
  \draw[->] ($(an1)!0.5!(ff)$) -- ++(3.1,0) |- (an2.east);
\end{tikzpicture}
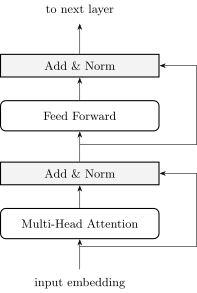
出力例:Transformer エンコーダブロック。$(a)!0.5!(b)$ で線分の中点を取り、そこから残差結合を分岐させて Add \\& Norm の東側へ入れる。
($(a)!0.5!(b)$) は calc の記法で「$a$ と $b$ の中点」。ここから分岐して -- ++(3.1,0) |- (an1.east) で「右へ 3.1、そこから直角に Add & Norm へ」と引き回します。
Multi-Head Attention の内部
MHA そのものを開くと、$V$・$K$・$Q$ をヘッドごとに Linear へ通し、Scaled Dot-Product Attention にかけ、結果を Concat して最後に Linear でまとめる構造です。ヘッドの繰り返しは、Linear〜Attention を破線の枠で囲んで「$h$ 個」と注記して表します。
\node (V) at (0,0) {$V$};  \node (K) at (1.7,0) {$K$};  \node (Q) at (3.4,0) {$Q$};
\node[lin, above=5mm of V] (lV) {Linear};
\node[lin, above=5mm of K] (lK) {Linear};
\node[lin, above=5mm of Q] (lQ) {Linear};
\node[op, above=9mm of lK]        (sdpa)   {Scaled Dot-Product\\Attention};
\node[op, above=7mm of sdpa, minimum width=46mm] (concat) {Concat};
\node[lin, above=6mm of concat, minimum width=22mm] (out) {Linear};

\draw[->] (V) -- (lV);  \draw[->] (K) -- (lK);  \draw[->] (Q) -- (lQ);
\draw[->] (lV) -- (sdpa); \draw[->] (lK) -- (sdpa); \draw[->] (lQ) -- (sdpa);
\draw[->] (sdpa) -- (concat);  \draw[->] (concat) -- (out);

\node[draw, dashed, fit=(lV)(lQ)(sdpa), inner sep=2.5mm,
      label={right:{$h$ heads}}] {};
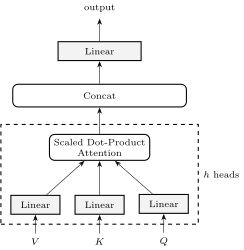
出力例:Multi-Head Attention の内部。\\node[fit=...] の破線枠でヘッドの繰り返しを囲み、label で「$h$ heads」と添える。
エンコーダ・デコーダ全体
ブロックを縦に積み、繰り返し数を破線枠の label で $N\times$ と示します。エンコーダの出力をデコーダの Cross Attention に渡す線は、-| で直角に引き回します。
\begin{tikzpicture}[
  >=Stealth, font=\scriptsize, node distance=4.5mm,
  blk/.style={draw, thick, rounded corners, minimum width=26mm, minimum height=5.5mm, align=center},
  an/.style ={draw, thick, fill=black!5, minimum width=26mm, minimum height=4.5mm, align=center},
  emb/.style={draw, thick, minimum width=26mm, minimum height=5mm, align=center},
]
  % ===== エンコーダ =====
  \coordinate (ein);
  \node[emb, above=6mm of ein] (eemb) {Input Embedding\\+ Positional};
  \node[blk, above=7mm of eemb] (emha) {Multi-Head Attention};
  \node[an,  above=of emha]     (ean1) {Add \& Norm};
  \node[blk, above=5mm of ean1] (eff)  {Feed Forward};
  \node[an,  above=of eff]      (ean2) {Add \& Norm};
  \draw[->] (ein) -- (eemb); \draw[->] (eemb) -- (emha);
  \draw[->] (emha) -- (ean1); \draw[->] (ean1) -- (eff); \draw[->] (eff) -- (ean2);
  \draw[->] ($(eemb)!0.5!(emha)$) -- ++(-2.1,0) |- (ean1.west);
  \draw[->] ($(ean1)!0.5!(eff)$)  -- ++(-2.1,0) |- (ean2.west);
  \node[draw, dashed, thick, fit=(emha)(ean2), inner sep=2.6mm,
        label={left:{$N\times$}}] {};
  \coordinate[above=6mm of ean2] (eout);
  \draw[->] (ean2) -- (eout);

  % ===== デコーダ(din を右にずらして同じ要領で)=====
  \coordinate (din) at (6.6,0);
  \node[emb, above=6mm of din] (demb) {Output Embedding\\+ Positional};
  \node[blk, above=7mm of demb] (dmha) {Masked Multi-Head Attn};
  \node[an,  above=of dmha]     (dan1) {Add \& Norm};
  \node[blk, above=5mm of dan1] (dca)  {Cross Attention};
  \node[an,  above=of dca]      (dan2) {Add \& Norm};
  \node[blk, above=5mm of dan2] (dff)  {Feed Forward};
  \node[an,  above=of dff]      (dan3) {Add \& Norm};
  \draw[->] (din) -- (demb); \draw[->] (demb) -- (dmha);
  \draw[->] (dmha) -- (dan1); \draw[->] (dan1) -- (dca);
  \draw[->] (dca) -- (dan2); \draw[->] (dan2) -- (dff); \draw[->] (dff) -- (dan3);
  \draw[->] ($(demb)!0.5!(dmha)$) -- ++(2.1,0) |- (dan1.east);
  \draw[->] ($(dan1)!0.5!(dca)$)  -- ++(2.1,0) |- (dan2.east);
  \draw[->] ($(dan2)!0.5!(dff)$)  -- ++(2.1,0) |- (dan3.east);
  \node[draw, dashed, thick, fit=(dmha)(dan3), inner sep=2.6mm,
        label={right:{$N\times$}}] {};
  \node[emb, above=6mm of dan3] (dlin) {Linear + Softmax};
  \draw[->] (dan3) -- (dlin); \draw[->] (dlin) -- ++(0,5mm);

  % エンコーダ出力 → Cross Attention(K,V)
  \draw[->] (eout) -- ++(0,4mm) -| ([xshift=-13mm]dca.west) -- (dca.west);
\end{tikzpicture}
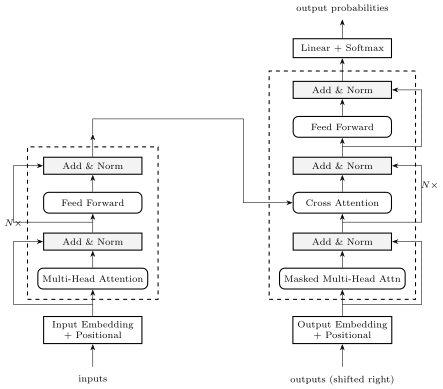
出力例:Transformer(エンコーダ・デコーダ)。各スタックを破線枠 + label の $N\\times$ で表し、エンコーダ出力を Cross Attention へ -| で結線する。
同じ部品を積む図なので、1 ブロックを \newcommand やスコープにまとめておき、エンコーダ・デコーダで使い回すとコードが短くなります。
さらに高度なモデル
より新しい・複雑なモデルも、これまでの部品(矩形ブロック、\foreach、calc の中点、fit の破線枠、直角配線)の組み合わせで描けます。
残差ブロック(ResNet)
weight → 活性化 → weight の本流と、入力をそのまま足し込む恒等写像(identity)の分岐からなります。分岐は中点から取り、+ の加算ノードへ戻します。
\coordinate (in);
\node[op, above=8mm of in] (w1) {$3\times3$ Conv};
\node[op, above=of w1] (r1) {ReLU};
\node[op, above=of r1] (w2) {$3\times3$ Conv};
\node[circle, draw, inner sep=1.5pt, above=8mm of w2] (add) {$+$};
\node[op, above=8mm of add] (r2) {ReLU};

\draw[->] (in) -- (w1); \draw[->] (w1) -- (r1); \draw[->] (r1) -- (w2);
\draw[->] (w2) -- (add); \draw[->] (add) -- (r2); \draw[->] (r2) -- ++(0,8mm);
\draw[->] ($(in)!0.5!(w1)$) -- ++(3.3,0)
      node[pos=0.72, above]{identity} |- (add.east);
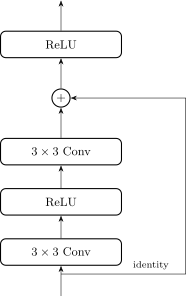
出力例:残差ブロック。恒等写像の分岐を中点から取り、加算ノード $+$ の東側へ |- で戻す。
U-Net
高さの違う矩形を左に下降・右に上昇で並べて砂時計形にし、対応する深さのブロックどうしをスキップ接続(破線の弧)で結びます。
\node[b, minimum height=22mm] (e1) at (0,0)     {};
\node[b, minimum height=15mm] (e2) at (1.3,-0.9){};
\node[b, minimum height=9mm]  (e3) at (2.6,-1.7){};
\node[b, minimum height=6mm]  (bn) at (3.9,-2.3){};
\node[b, minimum height=9mm]  (d3) at (5.2,-1.7){};
\node[b, minimum height=15mm] (d2) at (6.5,-0.9){};
\node[b, minimum height=22mm] (d1) at (7.8,0)   {};

\draw[->] (e1) -- (e2); \draw[->] (e2) -- (e3); \draw[->] (e3) -- (bn);
\draw[->] (bn) -- (d3); \draw[->] (d3) -- (d2); \draw[->] (d2) -- (d1);
\draw[->, dashed] (e1.north) to[bend left=18] (d1.north);
\draw[->, dashed] (e2.north) to[bend left=18] (d2.north);
\draw[->, dashed] (e3.north) to[bend left=18] (d3.north);
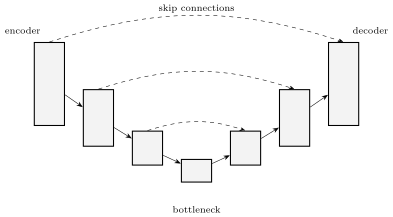
出力例:U-Net。矩形の $y$ をずらして砂時計形にし、to[bend left] の破線でスキップ接続を弧にする。
拡散モデル
前向き過程 $q$(データ→ノイズ)と逆向き過程 $p_\theta$(ノイズ→データ)を、状態 $x_0,\dots,x_T$ の間に上下 2 本の曲線矢印で描きます。逆向きの 1 ステップを担うのが U-Net などのデノイザです。
\node[xn] (X0) at (0,0)   {$x_0$};
\node[xn] (X1) at (2.9,0) {$x_1$};
\node     (Xd) at (5.8,0) {$\cdots$};
\node[xn] (XT) at (8.7,0) {$x_T$};

\foreach \a/\b in {X0/X1, X1/Xd, Xd/XT}{
  \draw[->] (\a) to[bend left=40] node[above]{$q(x_t\mid x_{t-1})$} (\b);
  \draw[->] (\b) to[bend left=40] node[below]{$p_\theta(x_{t-1}\mid x_t)$} (\a);
}
(x は TikZ 予約キーなのでスタイル名には使えません。xn などにします。)
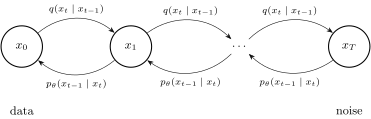
出力例:拡散モデル。to[bend left] で往復の弧を作り、前向き $q$ を上、逆向き $p_\theta$ を下に添える。
GAN
生成器 $G$ と識別器 $D$ を横に並べ、生成サンプル $\hat{x}$ と実データ $x$ の両方を $D$ に入れます。学習信号は破線で $D$ から $G$ へ戻します。
\node (z) at (0,0) {$z$};
\node[b, right=9mm of z] (G) {Generator\\$G$};
\node[b, right=30mm of G] (D) {Discriminator\\$D$};
\node[right=10mm of D] (out) {real / fake};
\coordinate (mid) at ($(G.east)!0.5!(D.west)$);
\node[above=12mm of mid] (xr) {$x$ (real)};

\draw[->] (z) -- (G);
\draw[->] (G) -- node[above]{$\hat{x}$} (D);
\draw[->] (xr) -| (D.north);
\draw[->] (D) -- (out);
\draw[->, dashed] (D.south) -- ++(0,-8mm) -| (G.south) node[pos=0.25, below]{gradient};
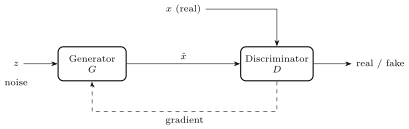
出力例:GAN。実データを -| で $D$ の上から入れ、学習信号を破線で $D$ から $G$ へ戻す。
VAE
エンコーダが $\mu,\sigma$ を出し、$\varepsilon$ を下から受けてサンプリングノード $z$ を作り、デコーダへ渡します。再パラメータ化の式はノードの上に添えます。
\node (x) at (0,0) {$x$};
\node[b, right=8mm of x] (E) {Encoder};
\node[right=9mm of E] (par) {$\mu,\ \sigma$};
\node[circle, draw, thick, inner sep=1.5pt, right=10mm of par] (z) {$z$};
\node[b, right=10mm of z] (D) {Decoder};
\node[right=8mm of D] (xh) {$\hat{x}$};
\node[below=10mm of z] (eps) {$\varepsilon \sim \mathcal{N}(0, I)$};

\draw[->] (x) -- (E);   \draw[->] (E) -- (par);
\draw[->] (par) -- (z); \draw[->] (z) -- (D);  \draw[->] (D) -- (xh);
\draw[->] (eps) -- (z);
\node[above=5mm of z] {$z = \mu + \sigma \odot \varepsilon$};
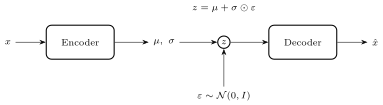
出力例:VAE。サンプリングを円ノードで表し、$\varepsilon$ を下から入れて再パラメータ化の式を上に添える。
Vision Transformer(ViT)
画像を格子で区切ってパッチを表し、線形射影・位置埋め込みを経て Transformer エンコーダと MLP ヘッドへ渡します。パッチの格子は矩形ノードに \draw で線を重ねて作ります。
\node[draw, thick, minimum width=13mm, minimum height=13mm] (img) at (0,0) {};
\foreach \k in {1,2} {
  \draw ([xshift=\k*13mm/3]img.south west) -- ([xshift=\k*13mm/3]img.north west);
  \draw ([yshift=\k*13mm/3]img.south west) -- ([yshift=\k*13mm/3]img.south east);
}
\node[below=1mm of img] {patches};
\node[b, right=10mm of img] (emb)  {Linear\\Projection};
\node[b, right=8mm of emb]  (enc)  {Transformer\\Encoder};
\node[b, right=8mm of enc]  (head) {MLP Head};
\node[right=8mm of head] (cls) {class};

\draw[->] (img) -- (emb);
\draw[->] (emb) -- node[above]{$+$ pos.} (enc);
\draw[->] (enc) -- (head);
\draw[->] (head) -- (cls);
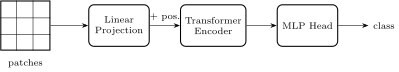
出力例:Vision Transformer。パッチの格子は矩形ノードの上に \\draw で分割線を重ねて表す。
Mixture of Experts
ルータから複数のエキスパートへ枝分かれし、出力を加算ノードでまとめます。エキスパートは \foreach に evaluate を付けて等間隔に配置します。
\node (in) at (0,-0.7) {$x$};
\node[b, right=9mm of in] (r) {Router};
\foreach \i [evaluate=\i as \y using {2.8-1.4*\i}] in {1,2,3,4}
  \node[b] (E\i) at (4.2,\y) {Expert \i};
\node[circle, draw, thick, inner sep=1.5pt] (sum) at (7.4,-0.7) {$\Sigma$};
\node[right=9mm of sum] (out) {$y$};

\draw[->] (in) -- (r);
\foreach \i in {1,2,3,4} {
  \draw[->] (r) -- (E\i);
  \draw[->] (E\i) -- (sum);
}
\draw[->] (sum) -- (out);
\node[below=6mm of r] {top-$k$ gating};
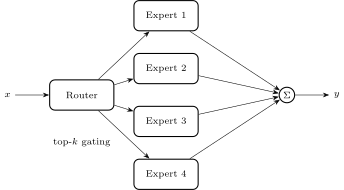
出力例:Mixture of Experts。\\foreach の evaluate でエキスパートの $y$ 座標を等間隔にし、出力を $\Sigma$ に集める。
これらに共通するのは「ブロックを置く → 直角・曲線で配線する → 繰り返しは枠で囲む」という手順で、部品はここまでと同じです。
描き分けのコツ
- ニューロン単位で見せる図(MLP・小さな RNN セル)は
\foreach+ 座標式 - アーキテクチャの流れを見せる図(CNN・Transformer・U-Net)は矩形ブロック +
positioning - 繰り返し構造(Transformer の $N\times$、MHA の $h$ ヘッド)は
fitの破線枠 +labelで示す - 分岐・合流(残差結合、スキップ接続、拡散の往復)は
calcの中点 +-|/to[bend] - 和文ラベルを図に入れない:
standaloneをpdflatex/latexで組むと日本語が通らない。ラベルは英語や数式にとどめ、説明は本文とキャプションに回す(和文を図に入れるなら LuaLaTeX+luatexja が必要) - 専用パッケージなら
neuralnetwork(LaTeX)や PlotNeuralNet(Python で.texを生成)もある
運用
図は standalone で 1 枚ずつ別ファイルにし、本文から \input します。ビルドは latexmk、環境の固定は TeX Live 入りコンテナの記事にまとめてあります。この記事の図も、上のコードを standalone でコンパイルして dvisvgm で SVG 化したものです。
関連記事
- 確率的生成モデルのグラフィカル表現を TikZ で描く — ノードとプレートの記法
- 圏論の可換図式を TikZ で描く — tikz-cd で矢印中心の図を組む
- 制御系のブロック線図を TikZ で描く — ブロックと配線の記法
- 状態遷移図を TikZ で描く — automata ライブラリで状態機械を描く
- latexmk — TikZ を含む文書のビルドを回す
まとめ
- 繰り返しは
\foreach、層は座標で管理しpositioningで積む。 - MLP はニューロン+二重ループ、CNN は高さの違う矩形、RNN は時刻方向の展開。
- Transformer はサブ層+残差結合、$N\times$ と $h$ ヘッドは
fitの破線枠で表す。 - ResNet の恒等写像、U-Net のスキップ接続、拡散の往復は、中点分岐と
-|/to[bend]で描く。 - 図に和文を入れないのが無難。凝るなら
neuralnetworkや PlotNeuralNet も選択肢。
矩形とループ、座標計算という道具立ては、TikZ の他の記事と共通です。GAN・VAE・ViT・MoE なども同じ部品で組めます。